
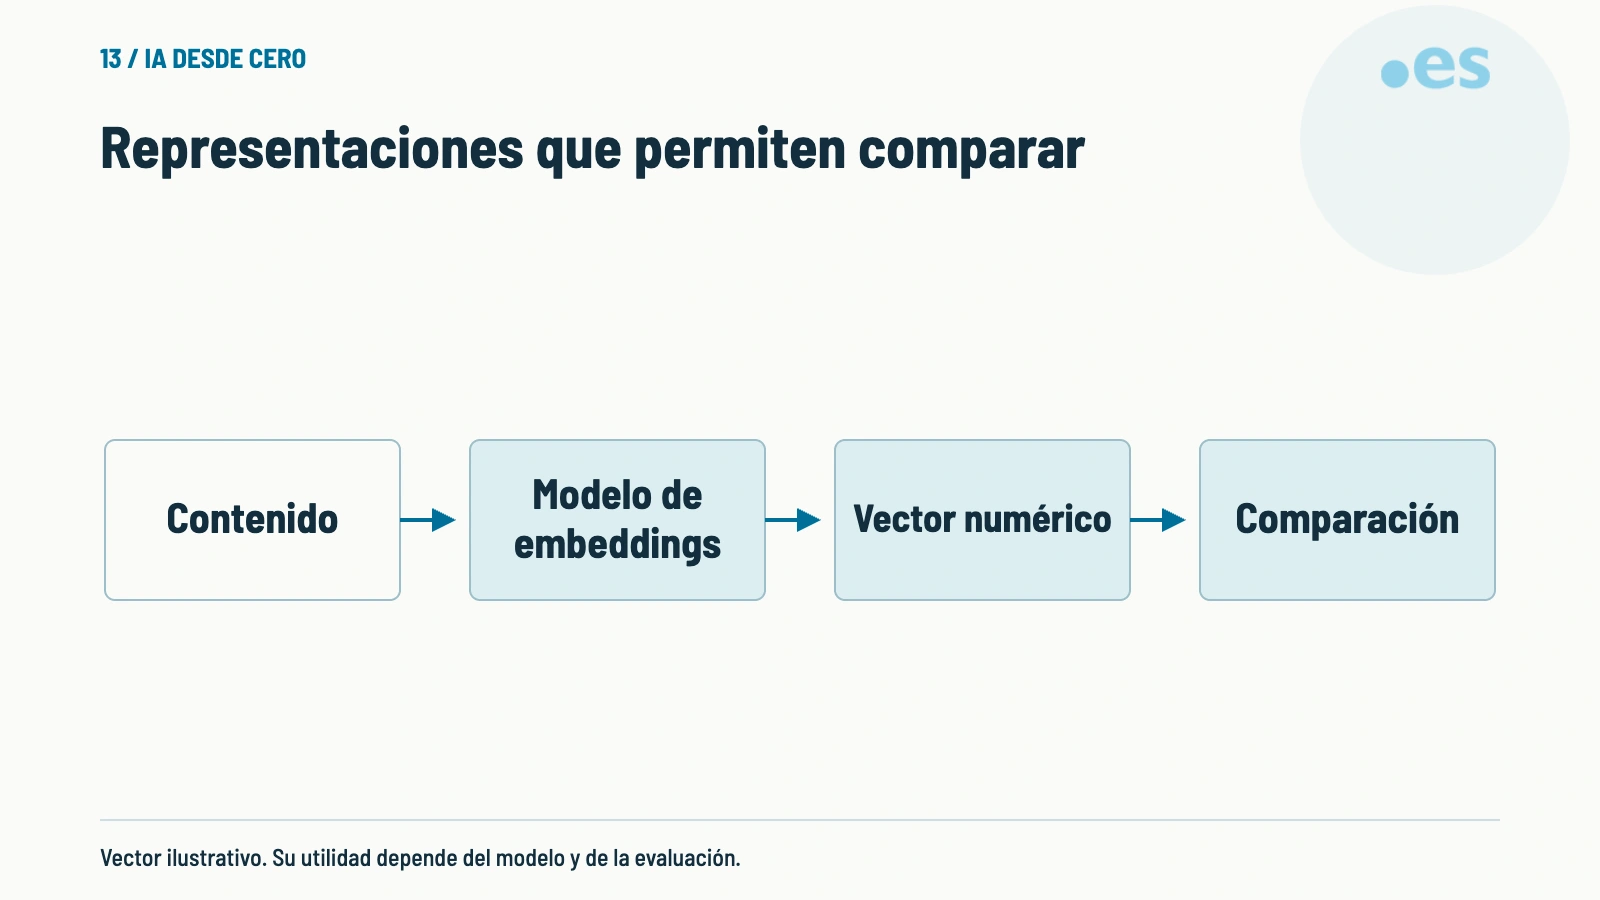
Un embedding es una forma de representar información, como textos o imágenes, en forma de números. Esta representación permite comparar elementos entre sí, incluso cuando no comparten palabras exactas. Los embeddings se generan mediante modelos de inteligencia artificial entrenados para capturar relaciones entre conceptos, pero no deben interpretarse como una explicación completa del significado. Su utilidad depende del entrenamiento del modelo y del contexto en el que se usen.
La idea, paso a paso
La idea principal detrás de los embeddings es convertir el contenido en vectores numéricos que reflejan su significado. Por ejemplo, dos palabras que tienen un significado similar, como "rápido" y "veloz", pueden tener vectores cercanos en el espacio numérico. Esto facilita comparaciones, búsquedas y operaciones matemáticas en el ámbito de la inteligencia artificial.
Un ejemplo para entenderlo
Una persona pregunta cómo restablecer el acceso y el documento usa la expresión «recuperar contraseña». Un modelo de embeddings adecuado puede situar ambos contenidos en representaciones compatibles con esa relación. Después debemos comprobar si el resultado realmente explica el procedimiento. La similitud ayuda a seleccionar candidatos; no valida automáticamente lo que dicen.
Qué conviene comprobar
Para ilustrar esto, imagina que estás buscando información sobre "cómo restablecer acceso" en un sitio web. Aunque el texto que encuentras diga "recuperar contraseña", los embeddings pueden identificar que ambos textos tienen un significado relacionado, incluso si no comparten palabras exactas. Este proceso es útil en sistemas de búsqueda y recuperación de información, donde se busca que las consultas y los documentos coincidan en intención, no solo en palabras.
Sin embargo, es importante tener en cuenta algunos errores frecuentes. Por ejemplo, los embeddings pueden fallar cuando se usan en contextos muy diferentes al de su entrenamiento. Un modelo entrenado para entender textos técnicos puede no manejar correctamente consultas sobre temas completamente distintos, como instrucciones de cocina o conversaciones informales. Además, si se cambia el modelo de embeddings, podría ser necesario regenerar todo el índice de datos para que funcione correctamente.
Una consulta y sus documentos deben estar representados en un espacio compatible. No basta con que dos vectores tengan el mismo número de componentes. Si cambias el modelo de embeddings, comprueba compatibilidad y considera volver a generar las representaciones del índice.
Pruébalo con un caso pequeño
Piensa en dos textos parecidos en palabras pero diferentes en intención.
Para revisar tu ejercicio, distingue qué dato entra, qué resultado esperas y con qué evidencia lo comprobarías. Si aparece una duda, anótala como tal en lugar de completar el dato. El propósito es detectar una decisión concreta que puedas justificar, no obtener una respuesta que solo suene convincente.
Cómo leer el esquema
Vector ilustrativo. Su utilidad depende del modelo y de la evaluación.
Fuentes
Documentación original utilizada para los conceptos de este artículo.