
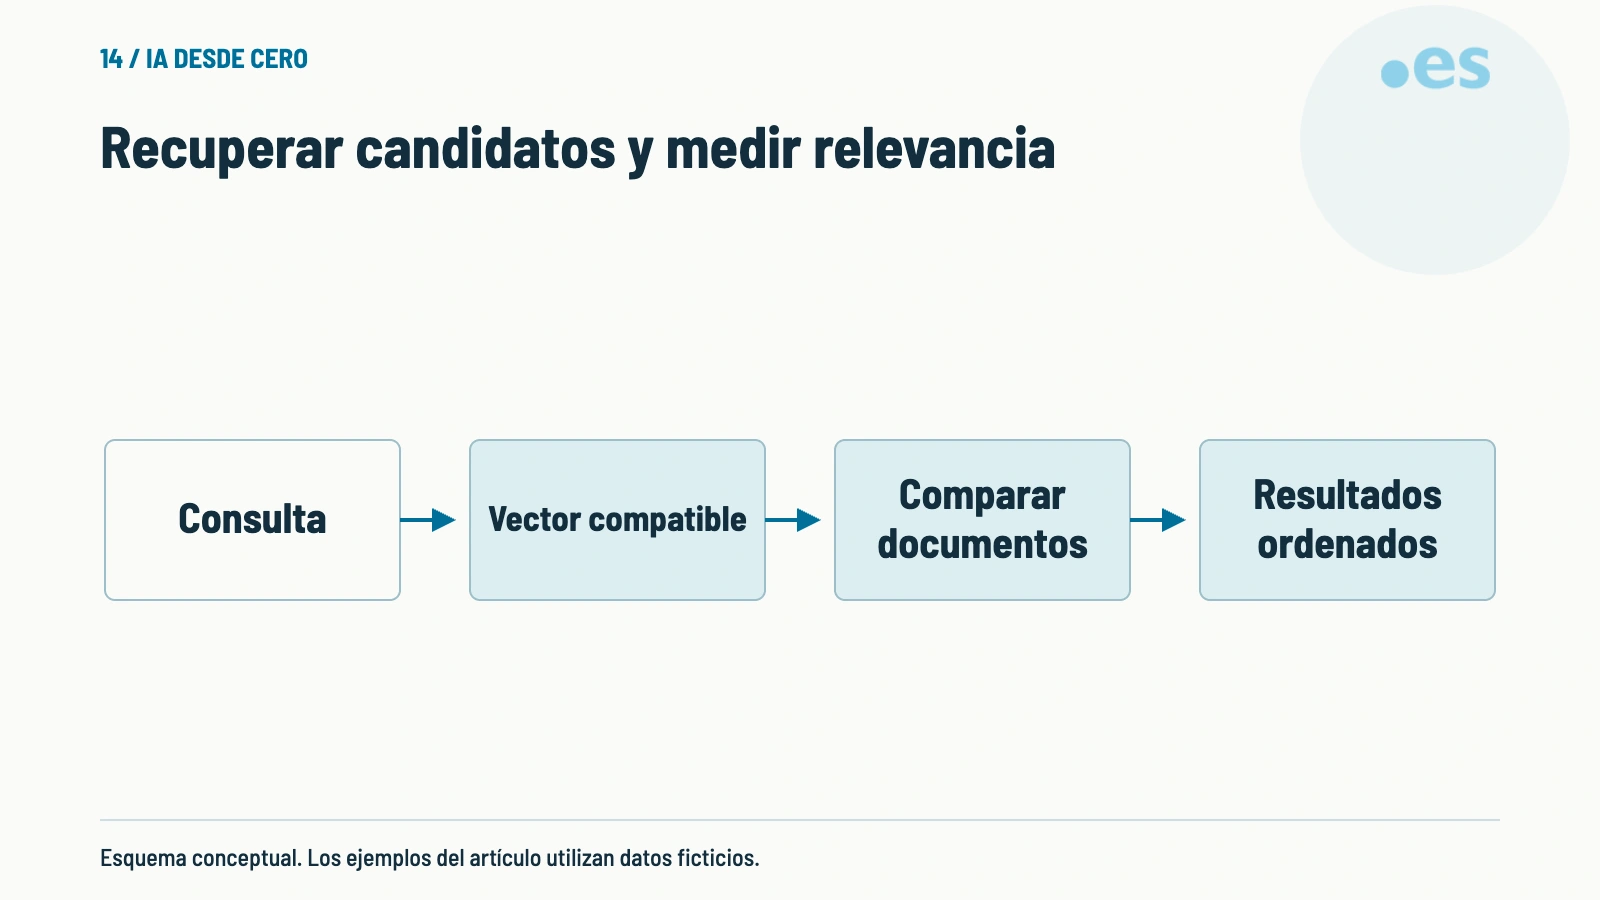
La búsqueda semántica es una técnica que permite encontrar información relevante basándose en el significado de las palabras, no solo en su aparición. Este enfoque se logra mediante el uso de embeddings, que son representaciones numéricas de las palabras o frases que capturan su contexto y significado. Una vez que la consulta se convierte en un vector compatible, se compara con otros vectores de documentos candidatos, y se evalúa la similitud entre ellos. Sin embargo, es importante entender que este proceso no garantiza la pertinencia absoluta de los resultados, por lo que siempre debe realizarse una evaluación adicional basada en el contexto del dominio.
La idea, paso a paso
La comparación entre embeddings se lleva a cabo usando métricas como la similitud del coseno, que mide el ángulo entre dos vectores. Cuanto menor sea el ángulo entre los vectores, mayor será la similitud coseno. Aunque esta métrica es útil, no debe interpretarse como una probabilidad de que el documento sea verdadero o correcto. La relevancia depende del diseño del sistema, de la calidad de los embeddings y de la naturaleza de los datos. Por eso, es fundamental que los resultados se evalúen manualmente o mediante pruebas con consultas reales del dominio para asegurar que respondan adecuadamente a las necesidades del usuario.
Un ejemplo para entenderlo
La consulta «límite de gastos de viaje» busca un concepto, mientras que «expediente AB-2048» necesita preservar una referencia concreta. En el primer caso puede ayudar una recuperación por significado. En el segundo conviene comprobar coincidencias exactas. El sistema puede combinar ambos métodos, siempre evaluando si devuelve el documento que responde a la consulta.
Qué conviene comprobar
Al aplicar la búsqueda semántica, es común cometer errores como confiar exclusivamente en un solo método, ya sea semántico o textual, sin considerar las ventajas y limitaciones de cada uno. Otro error frecuente es interpretar la puntuación de similitud como una medida de certeza absoluta, cuando en realidad refleja un grado de coincidencia contextual. Para evitar estos problemas, es importante entender los límites del sistema y complementar la búsqueda semántica con otros métodos, como la búsqueda por palabras clave o el uso de filtros basados en metadatos.
La similitud coseno depende del ángulo entre vectores, no de que estén cerca según cualquier medida de distancia. Su puntuación no es una probabilidad de verdad. Para identificadores, referencias o códigos exactos puede resultar útil combinar esta recuperación con búsqueda textual.
Pruébalo con un caso pequeño
Escribe una consulta conceptual y otra que contenga un identificador exacto.
Para revisar tu ejercicio, distingue qué dato entra, qué resultado esperas y con qué evidencia lo comprobarías. Si aparece una duda, anótala como tal en lugar de completar el dato. El propósito es detectar una decisión concreta que puedas justificar, no obtener una respuesta que solo suene convincente.
Cómo leer el esquema
La ilustración organiza los conceptos explicados en el artículo. Es un esquema educativo, no una medición de un sistema real.
Fuentes
Documentación original utilizada para los conceptos de este artículo.