
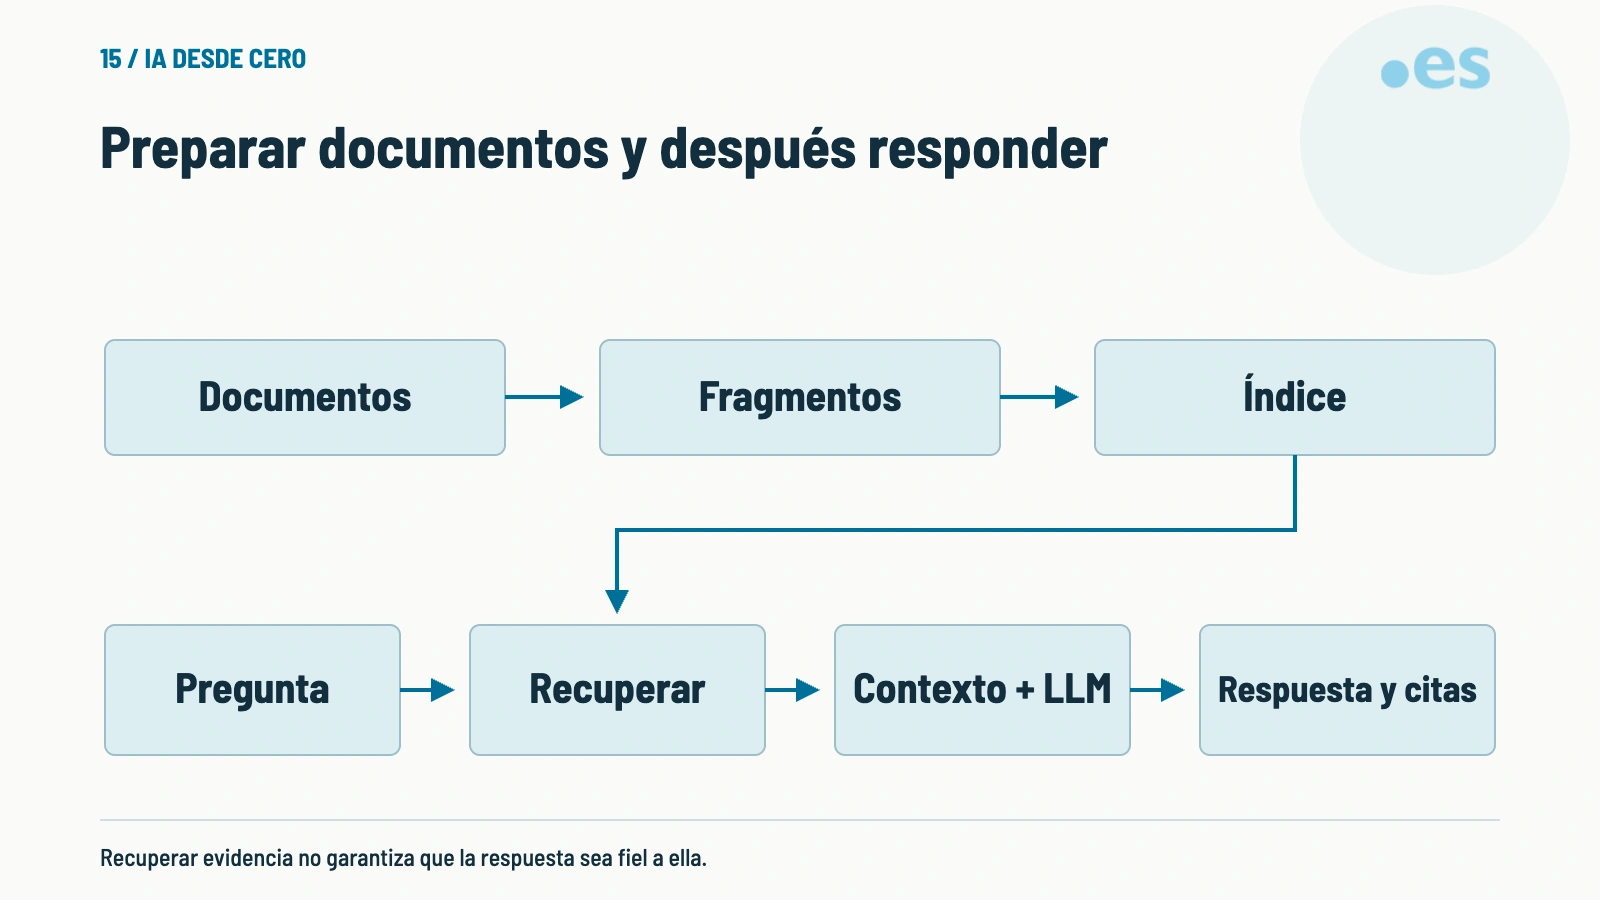
Un RAG, o generación aumentada con recuperación, es un enfoque que combina dos procesos clave: la recuperación de información relevante y la generación de respuestas. Su objetivo es mejorar la calidad de las respuestas de un modelo de lenguaje al proporcionarle información adicional antes de que responda a una pregunta. Este proceso no implica reentrenar el modelo, sino ofrecerle un contexto más completo basado en documentos o fuentes externas.
La idea, paso a paso
El funcionamiento de un RAG se divide en dos etapas principales: la indexación y la recuperación. Durante la indexación, los documentos relevantes se procesan y organizan en un índice que facilita la búsqueda. En la fase de recuperación, cuando se hace una pregunta, el sistema busca en ese índice los fragmentos de documento más relevantes para la consulta. Estos fragmentos se incluyen en el contexto que recibe el modelo antes de generar la respuesta. Esto permite al modelo basar sus respuestas en información específica y actualizada, en lugar de depender únicamente de su conocimiento previo.
Un ejemplo para entenderlo
Una pregunta sobre vacaciones llega a un sistema con documentos ficticios de una empresa. Primero recupera el apartado vigente y autorizado; después lo añade al contexto junto con la pregunta. La respuesta debe reflejar ese apartado y enlazarlo de forma verificable. Si no existe evidencia suficiente, el sistema necesita una conducta definida para indicar la ausencia.
Qué conviene comprobar
Una de las decisiones más comunes al implementar un RAG es determinar qué documentos incluir en el índice. No todos los documentos son igualmente relevantes, y elegir los adecuados puede mejorar significativamente la calidad de las respuestas. Además, es importante considerar la actualización de los documentos, ya que información antigua puede llevar a respuestas incorrectas. Otro error frecuente es no proporcionar al modelo una referencia verificable de los documentos utilizados, lo que puede dificultar la auditoría o la revisión de las respuestas.
Para comprender mejor el proceso, imagina que estás trabajando con un RAG que debe responder a una pregunta sobre un tema específico. Primero, el sistema recupera los documentos que contienen información relevante. Luego, esos documentos se dividen en fragmentos más pequeños, que se organizan en un índice. Cuando se hace una pregunta, el sistema busca en el índice los fragmentos más relevantes. Estos fragmentos se añaden al contexto del modelo, que los utiliza para generar una respuesta más precisa. Si el documento incluye una cita o una referencia específica, el modelo puede mencionarla como evidencia. Si no hay información disponible, el modelo informará que no tiene datos suficientes.
Si la recuperación no aporta evidencia suficiente, el sistema debe estar diseñado para abstenerse o pedir más información. El modelo no hará necesariamente esa comprobación de forma automática. También puede recibir un documento correcto y resumirlo mal: las citas y la fidelidad requieren evaluación.
Pruébalo con un caso pequeño
Dibuja qué ocurre al añadir un documento y qué ocurre al preguntar sobre él.
Para revisar tu ejercicio, distingue qué dato entra, qué resultado esperas y con qué evidencia lo comprobarías. Si aparece una duda, anótala como tal en lugar de completar el dato. El propósito es detectar una decisión concreta que puedas justificar, no obtener una respuesta que solo suene convincente.
Cómo leer el esquema
Recuperar evidencia no garantiza que la respuesta sea fiel a ella.
Fuentes
Documentación original utilizada para los conceptos de este artículo.