
Cuando trabajamos con modelos de inteligencia artificial, es común pensar que procesan el texto palabra por palabra. Sin embargo, en realidad, utilizan un sistema más complejo basado en unidades llamadas tokens. Un token puede corresponder a una palabra, un fragmento de una palabra, una puntuación o incluso bytes en algunos casos. Lo importante es entender que no existe una equivalencia fija entre palabras y tokens, ya que depende del tokenizador utilizado.
La idea, paso a paso
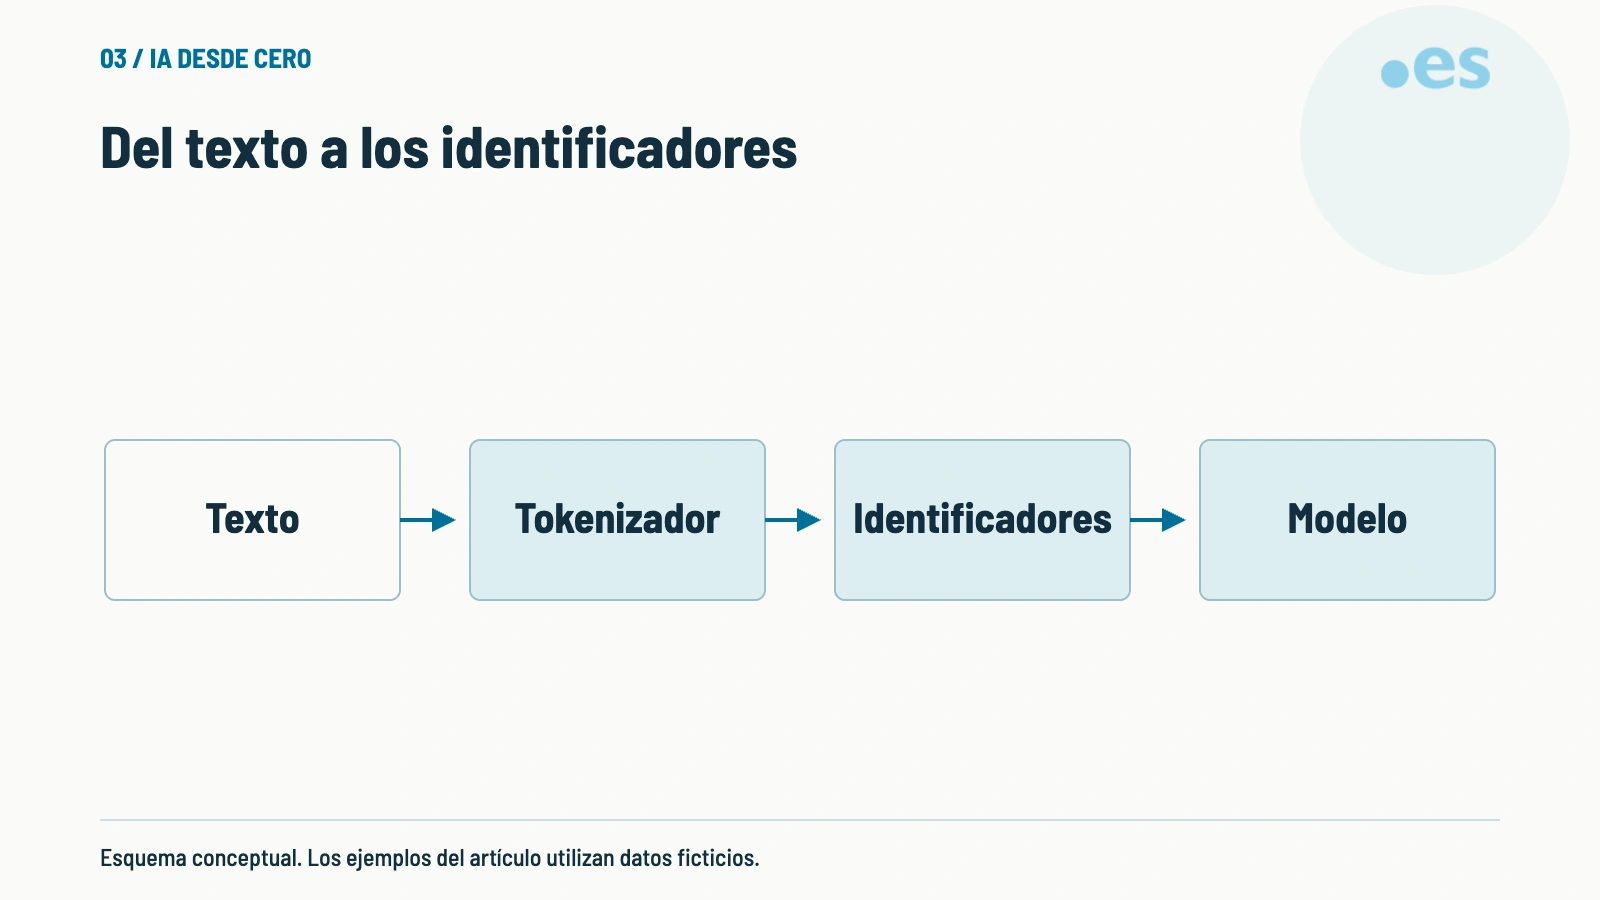
El proceso comienza con el tokenizador, que convierte el texto en una secuencia de identificadores. Estos identificadores no son las palabras en sí, sino representaciones que el modelo puede procesar. Por ejemplo, una palabra como “buenos” podría ser un token, pero también podría dividirse en “bue” y “nos” dependiendo del tokenizador. El modelo no interpreta directamente las palabras, sino que trabaja con estas representaciones numéricas. Luego, la salida del modelo se decodifica para convertirla nuevamente en texto comprensible. Este proceso influye en cómo se entiende y genera el lenguaje artificial.
Un ejemplo para entenderlo
Compara «buenos días», «tecnico_largo» y un emoji. No podemos asignarles un número universal de tokens solo mirando las palabras. El tokenizador asociado al modelo decidirá cómo representarlos. El ejercicio útil consiste en medir las tres entradas con ese tokenizador y conservar su nombre o versión para poder interpretar el resultado.
Qué conviene comprobar
Compara tres entradas ficticias: «buenos días», «tecnico_largo» y un emoji. Un tokenizador puede dividirlas de maneras diferentes. Para saber cuántos tokens ocupan, hay que usar el tokenizador de un modelo concreto; el esquema no representa una segmentación real medida.
Los ejemplos de palabras de este artículo no son una segmentación medida. En una aplicación se utiliza el tokenizador compatible con el modelo: intercambiarlos sin comprobar compatibilidad puede cambiar los identificadores y el comportamiento. Para obtener el recuento real hay que ejecutar ese tokenizador sobre el texto completo.
Pruébalo con un caso pequeño
Elige tres textos y explica por qué contar palabras no basta para comparar su tamaño en tokens.
Para revisar tu ejercicio, distingue qué dato entra, qué resultado esperas y con qué evidencia lo comprobarías. Si aparece una duda, anótala como tal en lugar de completar el dato. El propósito es detectar una decisión concreta que puedas justificar, no obtener una respuesta que solo suene convincente.
Cómo leer el esquema
La ilustración organiza los conceptos explicados en el artículo. Es un esquema educativo, no una medición de un sistema real.
Fuentes
Documentación original utilizada para los conceptos de este artículo.