
El concepto de "ventana de contexto" se refiere a la cantidad de información que un modelo de inteligencia artificial puede procesar en una sola interacción. Esta información incluye instrucciones, el historial de la conversación, documentos externos y el espacio reservado para la respuesta. Sin embargo, no implica que el modelo tenga acceso a toda la historia del usuario o a una memoria ilimitada. La ventana de contexto tiene un límite máximo, que varía según el modelo, y se mide en unidades llamadas "tokens". Un token puede ser una palabra, una parte de una palabra o un signo de puntuación.
La idea, paso a paso
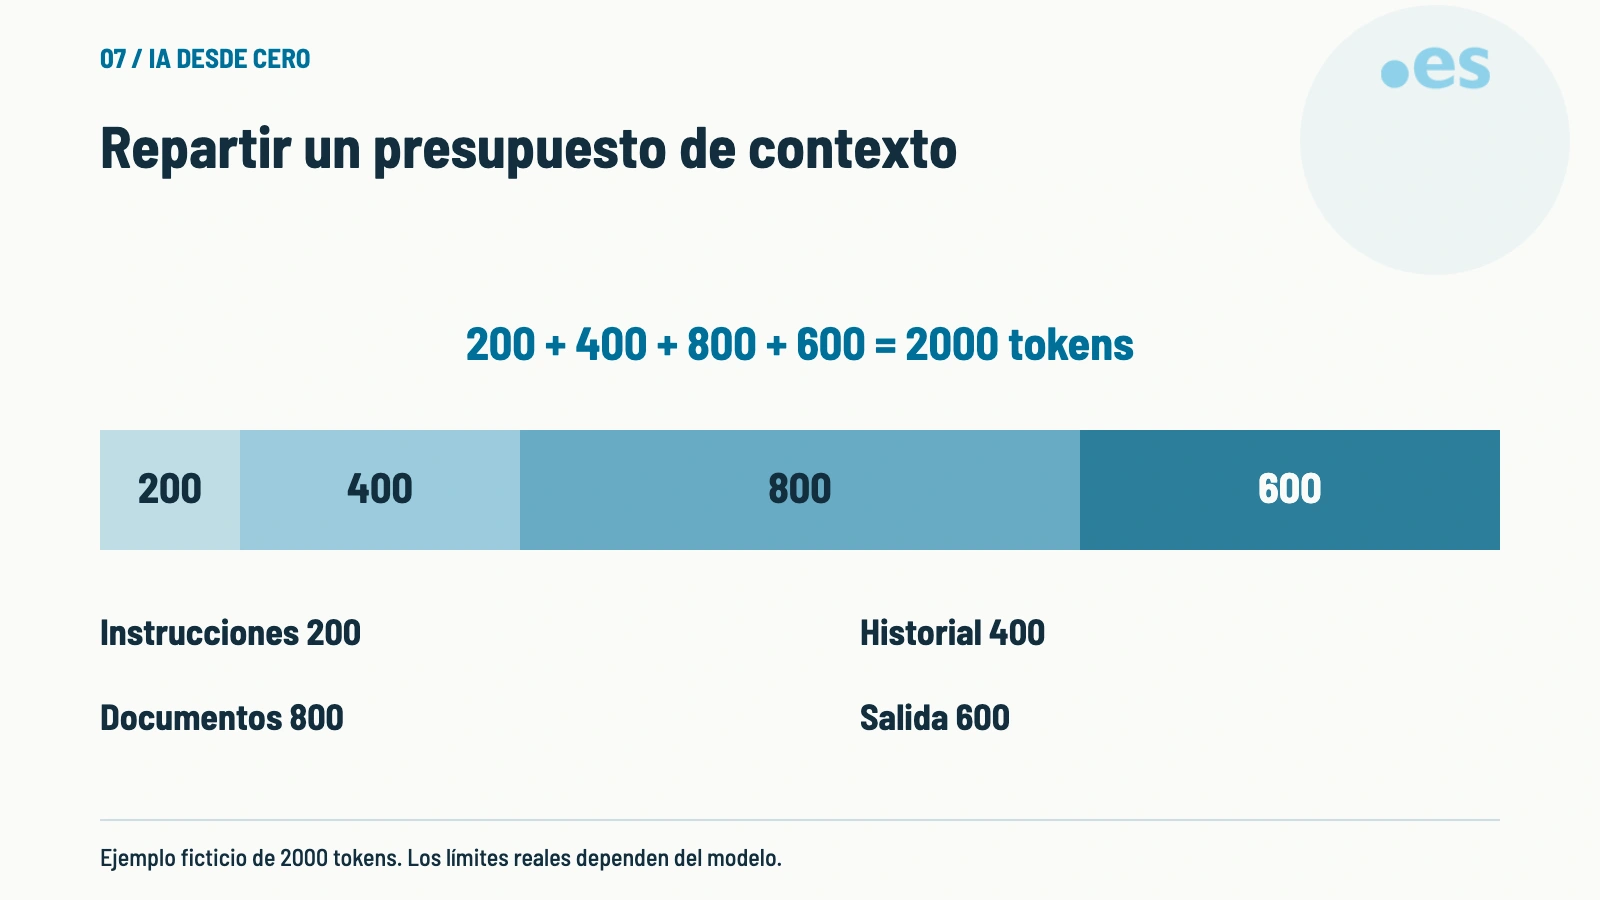
Por ejemplo, si un sistema tiene un presupuesto total de 2000 tokens, se podría distribuir de la siguiente manera: 200 tokens para instrucciones claras, 400 para el historial de la conversación, 800 para documentos externos y 600 para la salida esperada. Esta distribución es solo un ejemplo educativo, ya que en un entorno real se debe consultar siempre los límites del modelo y usar su tokenizador para contar con precisión. El gráfico de 2000 tokens mencionado en el brief no representa una capacidad real, sino una ilustración para mostrar cómo se reparte el presupuesto.
Un ejemplo para entenderlo
El esquema reparte un presupuesto ficticio de 2000 tokens: 200 para instrucciones, 400 para historial, 800 para documentos y 600 reservados para la salida. Si un documento necesita más espacio, primero revisamos qué contenido irrelevante se puede quitar o qué pasaje concreto conviene recuperar. No borramos la reserva de respuesta como si fuera un saludo redundante.
Qué conviene comprobar
En el ejemplo del esquema repartimos 2000 tokens entre instrucciones, historial, documentos y una reserva de salida. Son cifras ficticias. Si el documento útil ocupa más de lo previsto, podemos reducir saludos repetidos o mensajes antiguos, y seleccionar solo los pasajes necesarios. La reserva de salida se mantiene: sin ella podríamos preparar una entrada que deja poco espacio para responder.
Para decidir qué conservar, empieza por la pregunta del usuario y la información que permite responderla. Mantén las instrucciones autorizadas y las condiciones relevantes del documento. No cortes una excepción solo para que el texto encaje; si falta espacio, recupera un fragmento mejor o replantea la petición. Después comprueba el recuento con el tokenizador del modelo elegido.
El ejemplo de 2000 tokens es un presupuesto inventado para comprender el reparto. Cada modelo puede tener límites propios de entrada, salida y contexto combinado. Si una petición los supera, la aplicación puede rechazarla o truncarla según su implementación. No hay que quitar la reserva de salida como si fuera información redundante.
Pruébalo con un caso pequeño
Ordena qué conservar al reducir contexto: instrucciones, documento útil, saludos repetidos, respuesta prevista.
Para revisar tu ejercicio, distingue qué dato entra, qué resultado esperas y con qué evidencia lo comprobarías. Si aparece una duda, anótala como tal en lugar de completar el dato. El propósito es detectar una decisión concreta que puedas justificar, no obtener una respuesta que solo suene convincente.
Cómo leer el esquema
Ejemplo ficticio de 2000 tokens. Los límites reales dependen del modelo.
Fuentes
Documentación original utilizada para los conceptos de este artículo.