
La atención en los modelos de lenguaje, como los Transformers, es un mecanismo que permite al sistema relacionar diferentes partes de un texto. En lugar de tratar cada palabra de forma aislada, el modelo aprende a combinar las representaciones de los tokens (palabras o fragmentos de texto) según relaciones que detecta durante el entrenamiento. Esta capacidad no implica una comprensión consciente ni una atención similar a la humana, sino una forma de procesar información basada en patrones estadísticos. Por ejemplo, en la frase "Ana dejó la mochila junto a la chaqueta porque estaba mojada", el modelo puede aprender a asociar "mojada" con "chaqueta" en lugar de con "mochila", pero no garantiza que siempre resuelva ambigüedades de forma correcta.
La idea, paso a paso
Un Transformer está compuesto por varios bloques de atención, que permiten al modelo enfocarse en diferentes partes del texto al mismo tiempo, y por redes feed-forward, que realizan transformaciones no lineales en los datos. Estos bloques se aplican secuencialmente, con la ayuda de otras operaciones como la normalización y la suma residual. El modelo también incluye mecanismos que garantizan que, durante la generación de texto, los tokens futuros no se lean antes de ser producidos, algo fundamental en los modelos autoregresivos.
Un ejemplo para entenderlo
Considera la frase «Ana dejó la mochila junto a la chaqueta porque estaba mojada». El adjetivo puede referirse a la mochila o a la chaqueta. Un contexto adicional, como «había llovido sobre la mochila», ayuda a resolverlo. Las relaciones que procesa la atención hacen posible utilizar ese contexto, pero el acierto se comprueba en la salida.
Qué conviene comprobar
En el ejemplo mencionado, la ambigüedad de "mojada" puede ser interpretada de distintas formas: ¿se refiere a la mesa o al libro? Un Transformer puede aprender a relacionar "mojada" con "mesa" si en su entrenamiento ha visto muchos ejemplos donde esa relación se repite. Sin embargo, en situaciones nuevas o poco frecuentes, el modelo puede fallar. Esto no significa que el modelo no funcione, sino que su capacidad se basa en patrones aprendidos, no en una comprensión consciente. La arquitectura del Transformer no resuelve todas las ambigüedades, pero sí permite que el modelo tenga una mejor idea de qué partes del texto están relacionadas.
Al implementar un Transformer, es común cometer errores relacionados con la comprensión de cómo se manejan las relaciones entre tokens. Por ejemplo, algunos desarrolladores pueden pensar que el modelo entiende el contexto de manera similar a un ser humano, lo cual no es cierto. Otra decisión frecuente es ignorar la importancia de los bloques de atención, pensando que solo las redes feed-forward son relevantes. Pero en realidad, los bloques de atención son el corazón del Transformer, ya que son los que permiten al modelo enfocarse en partes específicas del texto.
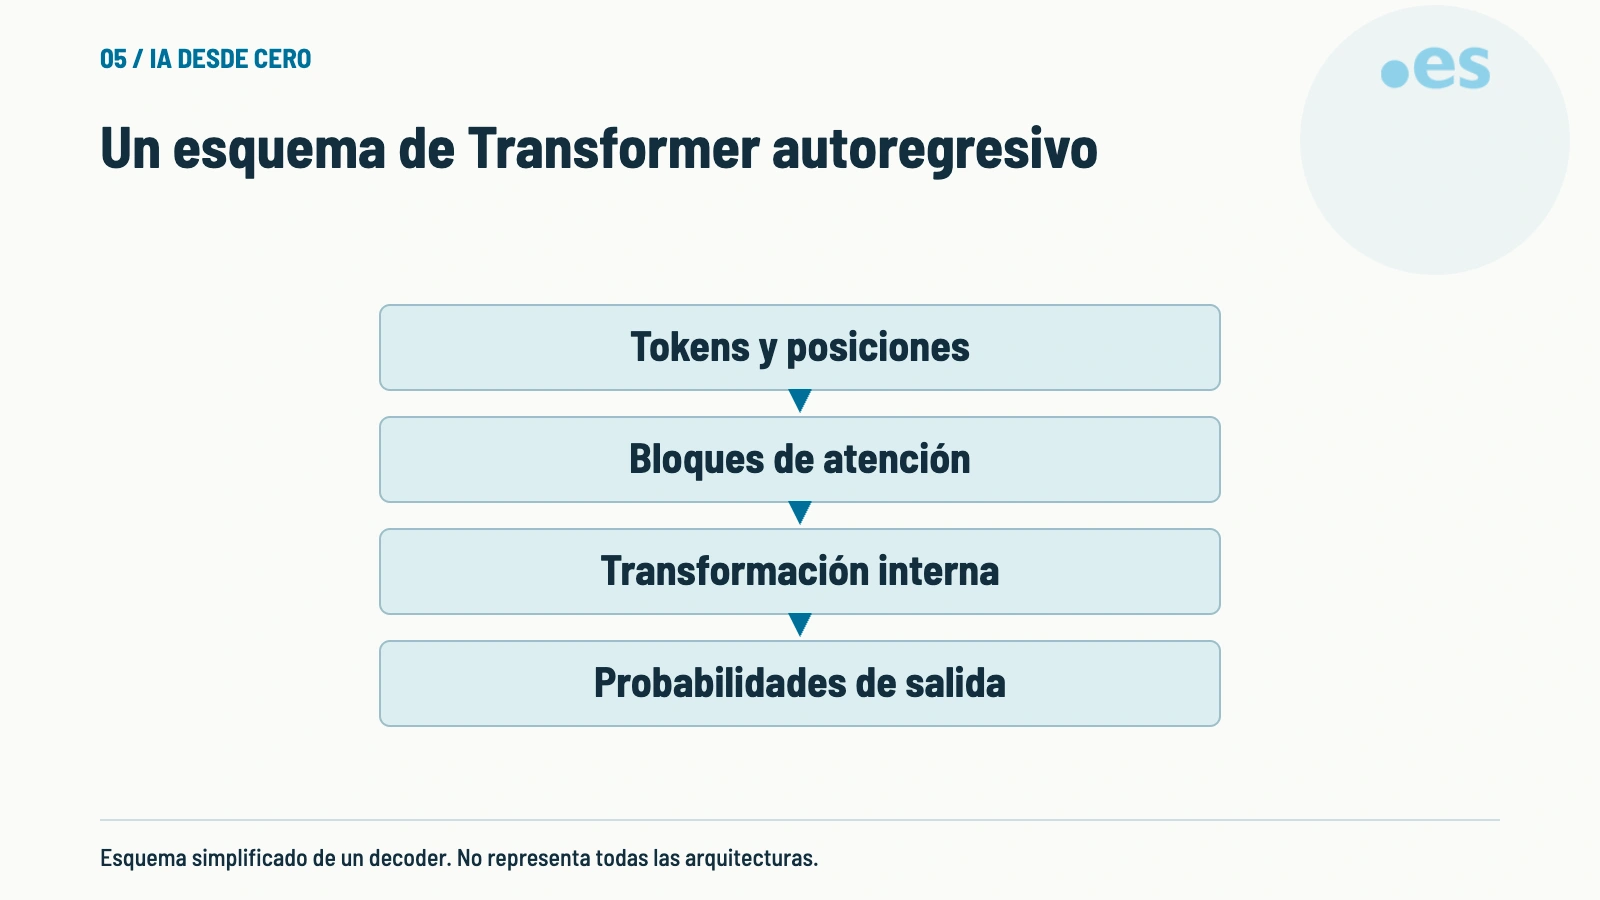
La atención causal permite que un modelo autoregresivo genere utilizando posiciones anteriores, sin acceder a tokens futuros de esa secuencia. El gráfico agrupa operaciones de un decoder para explicar el recorrido; omite detalles como normalización y conexiones residuales y no pretende describir todos los Transformers.
Pruébalo con un caso pequeño
Escribe una frase ambigua y señala qué contexto adicional necesitaría un lector o modelo.
Para revisar tu ejercicio, distingue qué dato entra, qué resultado esperas y con qué evidencia lo comprobarías. Si aparece una duda, anótala como tal en lugar de completar el dato. El propósito es detectar una decisión concreta que puedas justificar, no obtener una respuesta que solo suene convincente.
Cómo leer el esquema
Esquema simplificado de un decoder. No representa todas las arquitecturas.
Fuentes
Documentación original utilizada para los conceptos de este artículo.